
正在取代前端工程师的 AI,做不出游戏里最简单的一块面板

序
这篇文章中的问题也可以和当我们谈论 AI Native Game 的时候,我们在谈论什么、游戏行业如何引入 AI Agent放在一起阅读,以比较相近的概念如何在不同语境中展开。
这是我在网易实习期间的一次阶段性总结,也是在探索 AI 究竟应该如何介入游戏研发流程。
AI 一句话生成一个网页已经是日常。同一批模型,给它一张完整的视觉稿,让它产出游戏里的一块面板:一张背景、几个按钮、一列奖励格。这件事我做了两个月,到现在也不能说做成了,离网页那种顺畅差得很远。
为什么?
游戏 UI 更复杂吗?从上限看反而是 Web 更强。Coherent Gameface 就是拿 HTML/CSS/JS 写游戏 UI 的中间件,Minecraft、Civilization VII、Alan Wake 2 都在用它;格式层面同样没什么门槛,Unity 新做的 UXML 和 USS 写起来就是标签加样式表;Cocos 和 XGUI 的界面文件则是更简单的 JSON 或各种变体。Unreal 的 UMG 确实是里面最复杂的,但它也暴露了大量标准接口,够我们程序化地把一个界面拼出来。
游戏 UI 需要艺术设计吗?如果起点是策划案,那确实是问题。但真实分工里,视觉稿这一步 GUI 设计师早就做完了。剩下的是把它翻译成引擎里的 UI 工程文件,不需要美感,也不需要创造力,需要的是细心和大量重复。而这恰恰是 AI 本该比任何人都强的地方。
AI 依旧做不到。无论是商业引擎自带的 AI 工具,还是各个团队在做的内部方案,没有任何一个能说自己彻底解决了这个问题,然后推广出去让所有人一起用。
在正文展开之前,这里会先留下两条会贯穿全文的 Take Home Message:
- 网易可能是最适合做 UI 工作流 AI 化研究的公司,同时也是最不适合真正做成它的公司。 一家公司里同时有 Unity、Unreal 和多个自研引擎,市面上几乎所有的游戏 UI 方案你都能找到对应的团队。这意味着共性问题会暴露得更快。但反过来,技术路线越多,适配工作就越没有尽头,corner case 也越难穷举。
- 动手做一个 AI Agent 之前,最该问清楚的是目标。 是给现在的人配一个 Copilot 来提效,还是让 Agent 接管某个岗位或某道流程的全部工作?这两个目标听起来只差一步,实际可能是完全不同的技术路线和完全不同的成本。
我最近做了什么
UI Agent 尝试解决的问题
游戏 UI 的生产链条并不短。策划提出需求,UX 给出交互方案,GUI 产出视觉设计,UIP 在引擎里搭建工程,VX 补上特效与动画,最后由程序接入游戏逻辑。UI Agent 想做的不是在其中增加一个新的助手,而是缩短这条跨岗位的生产链。
最理想的形态可以参照今天的 Coding Agent:给出一段文字需求,直接得到能够运行的产物。但 UI 生产链上的每一环并不都适合交给 AI。审美和设计意图仍然需要人来判断,AI 更适合接手后面的重复劳动。因此我们把边界放在 UIP:输入已经定稿的设计稿,输出能够进入项目的 UI 工程与配套代码。
开发这类系统之前,首先要明确输入和输出。这里的输入是 Figma 或 PSD 设计稿,加上少量策划信息;输出是完整的 UI 工程文件和对应的程序代码。
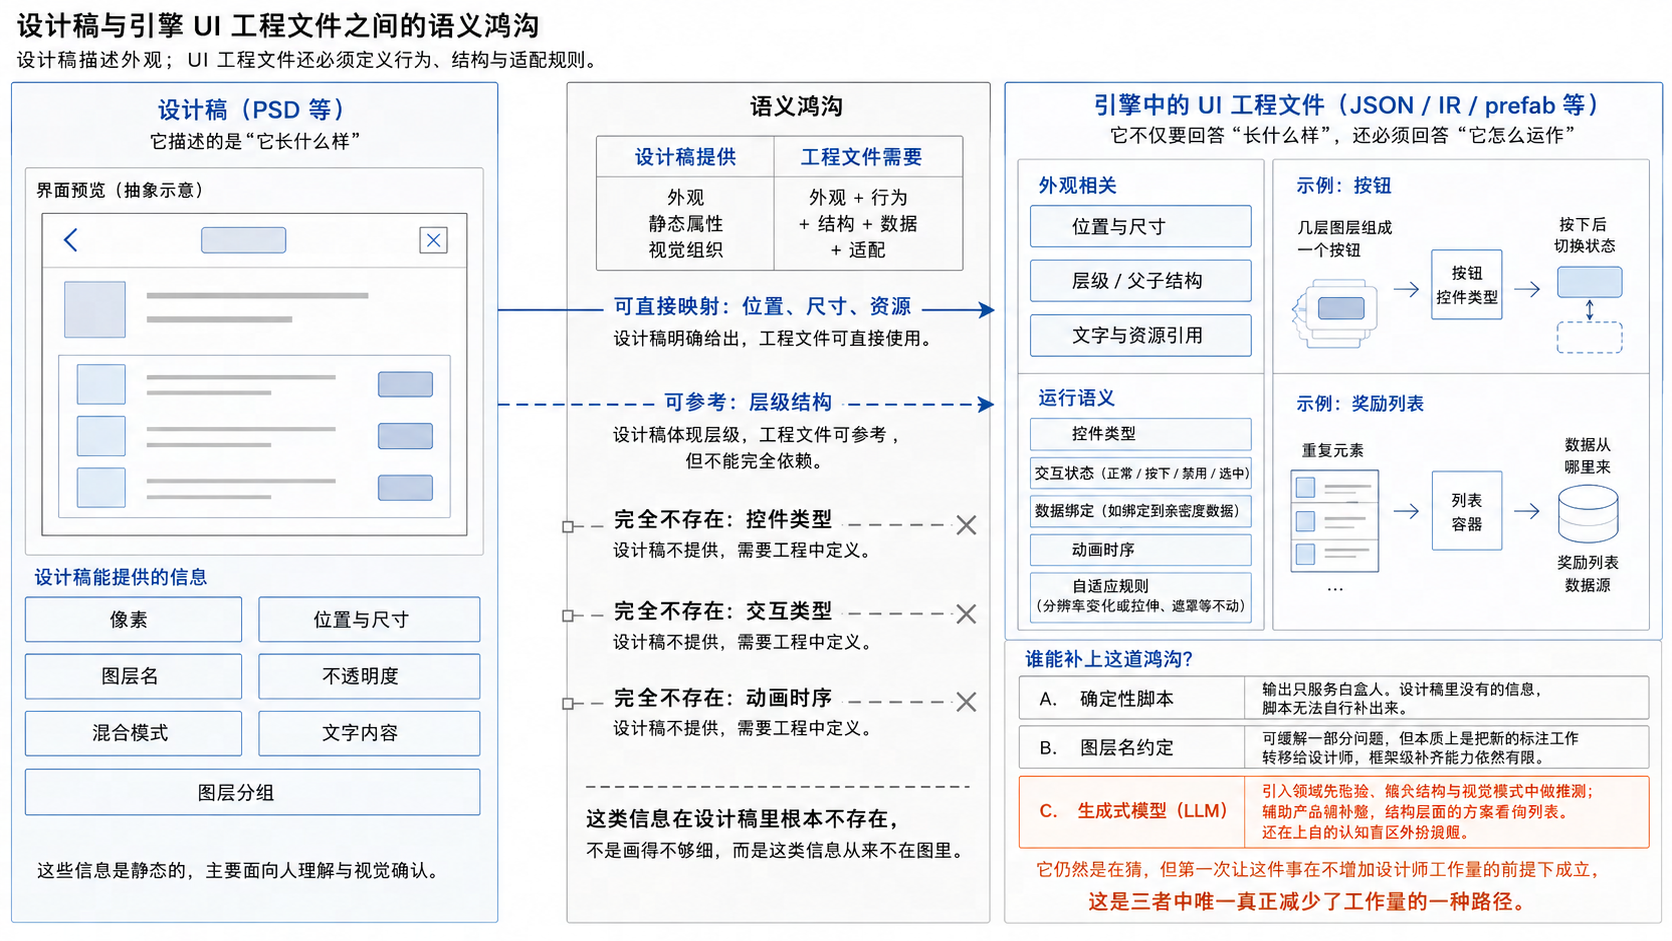
把输入和输出摆在一起,问题就很清楚了。设计稿描述的是“它长什么样”,UI 工程文件还要回答“它怎么运作”。哪些图层组成一个按钮,按下后切换到什么状态,奖励列表的数据从哪里来,分辨率变化后谁拉伸、谁保持不动,这些信息并不存在于静态设计稿中。
这也是过去的自动化方案很难成立的原因。确定性脚本的输出只能来自输入,设计稿里没有的信息,脚本无法自己补出来。要求设计师在图层名里添加约定字段可以缓解一部分问题,但同时也把新的工作推给了设计师。
生成式模型带来了另一个信息源:预训练中积累的先验。模型看到一排等距、结构相同的元素,可以推测它是列表;看到右上角的小叉,也能推测它是关闭按钮。它仍然是在猜,但这种猜测第一次让这件事在原理上可解:不增加设计师的工作量,也能减少后面那一段的人力。
Stage1:不要让模型直接写最终文件
最初的思路很直接:既然游戏 UI 工程和网页 UI 工程没有本质区别,就让 AI 像写网页一样把它写出来。我们把领域知识和操作步骤写进 Skill,告诉 Agent 如何解析 PSD、导出切图、初始化工程、生成 prefab 和执行校验。Agent 读完这份手册,再依次调用十来个命令行工具。这个版本符合直觉,也确实能够生成文件。 问题是,生成出来的文件大多数打不开。一个整页 UI 工程通常是几十个节点、几千行 JSON。每个节点都有自己的 transform、锚点、偏移、尺寸和组件列表。在模型几乎没有见过这种格式的情况下,它一定会写错某些字段,然后把大量时间耗在修改格式错误上。最初的测试中,一次生成大约需要十分钟,其中差不多一半都在反复修文件。
那干脆不再让模型写最终文件。我们增加了一层更小的语义 IR,让模型只描述“这是一个按钮”“标签在这里”“这些元素属于同一组”,坐标换算、fuid、组件列表和类型映射则交给确定性编译器。格式错误因此基本消失,IR 也成为一次生成的记录。人可以直接检查和修改它,而不必面对几千行的目标文件。
说白了就是造了一门更高级的语言(DSL),让模型写高级语言,其余交给编译器。高级语言比低级语言好学,对人和对模型都一样。
Stage2:把原型变成工程管线
IR 和编译器解决了“文件写得对”,但真实设计稿怎么进系统,生成的结果又怎么验证?
Stage2 没有更换前面的技术路线,而是把已有的原型补成一条能够处理真实输入、生成真实工程并接受真实验证的管线。
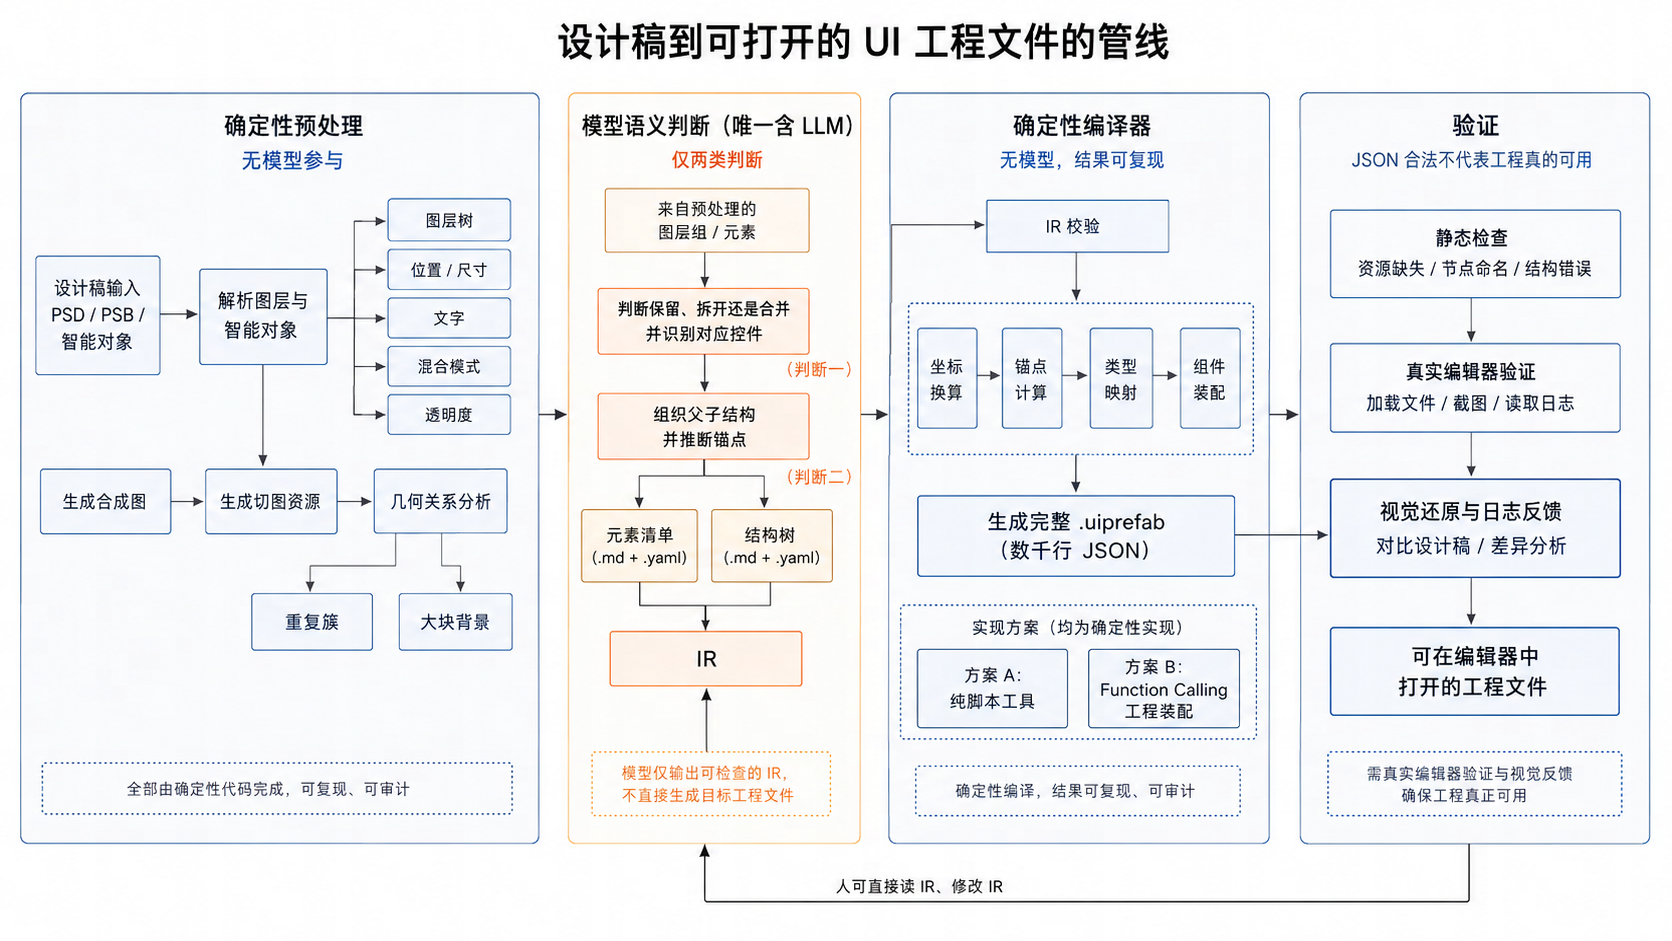
第一段是确定性预处理。系统解析 PSD/PSB 和智能对象,提取图层树、位置尺寸、文字、混合模式与透明度,生成合成图和切图资源,再用几何关系预先找出重复簇和大块背景。
第二段才轮到模型。它只做两类语义判断:先判断一组图层该保留、拆开还是合并,各自对应什么控件;再把这些元素组织成父子结构,并推断锚点。结果分别写进元素清单和结构树,一份 .md 文档搭配一些 .yaml 文件组成 IR。人可以直接检查它,模型也不用再写几千行的目标文件。
第三段是确定性编译器。IR 通过校验后,由编译器负责坐标换算、锚点计算、类型映射和组件装配,最后生成完整的 .uiprefab。当然在真实项目中我们实际上保留了两套编译方案,一套纯粹的脚本工具以及一套基于 Function Calling 的工程装配方案,后面展开聊。
最后是验证。静态检查覆盖资源缺失、节点命名和结构错误等问题,通过以后还要交给真实编辑器,加载文件、截图并读取日志。JSON 合法不代表工程真的能用,编辑器的视觉还原也是重要反馈信号。
到这一步,这套系统能做的已经比生成一个文件多了。它有了明确的输入契约、一个人和模型都能读的中间层、一个结果可复现的后端,以及自我验证的机制。它能完整地跑通设计稿,实现了现有路线的工程闭环,也暴露了新的问题。
Stage3:把流程本身也变成代码
Stage3 的管线已经能跑通,但又慢又不稳定。日志里充满报错、修复和重试;Skill 里几句提示的变化,就可能让整个流程在意想不到的地方崩掉。
根源在哪?
所谓流程,其实只是一份手册。那十来个步骤的调用顺序、失败之后该做什么、什么时候重试、什么时候放弃,全都写在一份给模型读的手册里。这份手册只能告诉模型该做什么,不能强制它按顺序执行。后果有两个:不可复现,同一张设计稿跑两次,中间经过的路径可能不同,结果也不同;失败没有归属。传输超时、模型输出被校验器拒绝、切图资源缺失、编辑器打不开,很多错误都没有清晰的处理路径,模型很多时候只能再来一次。
所以 Stage3 做的事情很简单:把流程从自然语言搬进代码,搭建一个工作流系统。
我们把整个生成过程声明成一张图,一共 54 个节点,其中真正调用模型的只有 10 个。每个节点都有明确的输入、输出和可返回动作,流程只能沿着预先声明的连边推进。模型仍然可以做判断,但它不能随意改变执行顺序,也不能在失败后自行发明一种处理方式。每个动作都带有明确的语义,例如申请人工接入、外部服务调用失败、函数请求错误、装配出错。
重试和回修需要分开处理。
传输层失败,例如超时、连接断开、响应不完整或 JSON 无法解析,系统就在当前节点重试。如果模型输出已经完整返回,只是没有通过检查,系统会根据错误类型定位责任节点,把检查报告带回去重新执行,这就是回修。校验器不再只负责宣布失败,还要告诉流程哪里错了、应该回到哪里修。(在此之前,校验器只是一段返回真假的脚本:它能拦住错误,却不会告诉后续流程该怎么做。)
运行状态会持续写进磁盘日志,每个节点还会留下 checkpoint。日志保存一次运行的完整轨迹,checkpoint 则支持从出错节点恢复和复现,不必每次都从头再跑。这些改动让 UI Agent 更容易稳定地运行和迭代。
但稳定和有用是两件事。这条流程能可靠地把一张设计稿从头做到尾,代价是每一次都真的从头做到尾;而在真实项目里,从头构建的界面只是少数。
Stage4:真实工程里的 UI,不是每次都要新建
成熟项目里的 UI 很少从零开始。一个项目运行得越久,复用已有界面进行修改的情况就越多。“照着这张设计稿,把原来的界面改成新的”才是更常见的需求。Stage4 因此不再只问怎样生成一个界面,而是开始处理已有工程应该怎样修改。
具体做法是引入一份声明文件,我们叫它蓝图。它声明以下几类内容:
- 参照件:作为骨架的工程文件
- 产出物的来源:每个要重做的部分对应设计稿里的哪个图层路径
- 绑定目标:这些产出物装到参照件的哪个节点上,用哪种装配方式
- 保留与排除:哪些节点必须原样保留,哪些设计稿路径不参与
运行时,系统先复制参照件,只重新生成蓝图声明范围内的内容,再把它们装回指定位置。需要修改的部分通常不到整个页面的一半,已有工程里的节点结构、布局和逻辑接口可以继续复用。
装配采用白名单制。五种装配器分别只允许修改少量明确列出的字段。例如列表装配器只能替换 XImage 引用,挂点装配器只能修改 XControl 路径,不能触碰挂点本身的位置、旋转和缩放。即使模型判断错误,它能够破坏的范围也被限制在蓝图声明之内。这和前面用编译器约束最终文件是同一个思路。
蓝图这条路稳定得多。最近四份蓝图跨了多张真实设计稿,都跑完了整条流程,耗时比从头生成低一截(蓝图生成耗时 1 分钟左右,有动画会略久,低于新建的 3-10 分钟)。这个提升不是模型变强了,是我们提供了更多知识,只让模型做更少的事。
这笔交易划不划算,取决于蓝图能被复用多少次。创建蓝图本身也需要成本(有自动创建但不够好用),换一个项目与一套规范,这些蓝图一份也带不走。
从不同方案的差异聊聊我们对问题的理解
如何复用控件:工作不应该转移
游戏 UI 和 WebUI 的一个重要差别是控件复用方式。Web 项目通常同时编写界面和逻辑,模型可以直接生成两者。游戏 UI 的视觉资产和程序逻辑则由不同岗位完成,所以我们会把按钮、列表、弹窗等高频结构封装成 prefab,减少后续重复搭建和接入的成本。
这套系统原本是为人设计的。人花几天时间就能熟悉一个项目的模板仓库,但模型很难获得相同的知识。公开的 WebUI 语料很多,游戏 UI 工程语料却很少,自研引擎的数据更不可能进入模型训练。过去封装得越充分,人用起来越方便,模型需要补充的项目知识反而越多。
我们想利用生成式语言模型的 zero-shot 泛化能力去解决 UIP 的问题,奈何模型压根没有在相关数据上训练过,那自然会比做 WebUI 困难得多。
那么我们应该如何解决这个问题?
- 做大规模多模态预训练,让模型直接学习引擎和控件
- 建立控件语义知识库,在运行时把项目知识提供给模型
- 通过多模态检索,从存量资产中寻找可以复用的控件
- 在 Figma 或 PSD 中提前标注控件类型
大规模预训练最直接,但成本也最高。只有 Unity、Unreal 这类商业引擎的开发者可能收集到足够的数据,小众技术栈和自研引擎几乎没有条件走这条路。即使是商业引擎,目前也还没有靠预训练彻底解决游戏 UI 的生成问题。
知识库是短期内更现实的办法。模型不知道项目里有哪些控件,就把控件说明、使用条件和接口提供给它。我们已经做过,能解决一部分问题。问题是,项目里的 prefab 数量可能非常多,其中一部分知识还必须结合图片才能理解,全部塞进 Context 很快就会失控。视觉检索可以补上这一点:模型不必先准确判断控件类型,只需要从已有界面中找到外观和结构接近的资产,再读取对应的工程信息。
我最不看好的是前置标注。它通常能够做出最好的生成效果,因为设计师已经提前把系统缺少的语义补齐了。但这并没有消除工作,只是把 UIP 的一部分劳动转移给了 GUI。LLM 出现以前,类似的图层命名、结构整理和控件标注方案已经出现过很多次,最后往往停留在 Demo 阶段。评价 UI 自动化不能只看生成结果,还要看整条管线有没有减少工作。
KM 上其他团队的方案我大致看了一圈。项目组的程序基本都走知识库:靠训练语料里那点少量暴露撑起 zero-shot,再注入一些项目内部的规范(也就是 SPEC)。AI Lab 和 XGUI 反过来,靠标注和预先分层压低 LLM 的介入,换更快更稳的生成。
离项目越近的人越愿意把知识喂给模型,离项目越远的人越倾向于把不确定性挡在模型之前,这是一个有趣的发现。
文件格式决定技术路线,也决定 Agent 如何与其交互
前面提到,确定性编译器之外,我们还保留了一套基于 Function Calling 的实现。Agent 不再生成完整的目标文件,而是调用一组工具,逐步搭建和修改 UI。为什么同一个项目里要保留两条路线?这个问题要从 UI 工程文件本身说起。
市面上的 UI 工程格式大致可以分成三类:
- 以 Unity UGUI 为代表的序列化文本。
.prefab、.unity、.csd和.uiprefab都属于这条路线。工程由编辑器修改,再序列化成类似 JSON 或 YAML 的长文本。 - 以 WebUI 和 Unity UI Toolkit 为代表的声明式格式。结构、样式和渲染相对分离,文件原本就考虑了人工编写、版本管理和分支合并。
- 以 Unreal
.uasset为代表的二进制资产。模型无法直接读写,只能通过编辑器及其暴露的接口操作。
文章标题说 AI 能写好 WebUI,却写不好游戏 UI,其实和文件格式本身也有关系。UGUI 的 prefab 同样是文本,模型却很难直接修改。因为这些文件只是编辑器的序列化结果,从来不是为人手写准备的。一个字段或引用改错,整个文件就可能无法加载。到这里,标题里的那点标题党需要稍微收回来:文本格式不等于适合模型编写。
三类格式自然导向了三种自动化路线。UGUI 这类可读但不适合直接编辑的序列化文本,更适合增加一层 IR 或 DSL,再由确定性编译器生成最终文件;WebUI 可以直接利用模型已有的代码能力和训练语料;面对 .uasset 这样的二进制资产,则只能让 Agent 制定修改计划,再通过编辑器接口逐步执行。
但能不能生成只是问题的一半。Coding Agent 在最近半年里的进展,不只来自基础模型变强,也来自代码天然拥有便宜而密集的反馈。网页有语法检查、运行时报错、DOM 状态和浏览器截图,模型每次修改后都能很快知道发生了什么。UI 编译器通常只能告诉你文件是否合法,却很难判断控件类型是否正确、结构是否合理、视觉还原是否达标。这些反馈都需要另外设计。
用工具去逐个节点地搭建 UI 工程可能会导致更多轮的决策与 Token 消耗(程序化函数调用 Programmatic Tool Calling 可以缓解一部分),但设计一套好的工具反馈大概率比做好编译反馈更容易。一套好的工具也不只是工具,还是模型能够认识和接触到的整个世界。对 AI 而言,在 zero-shot 上学习工具也比学习 DSL 更为简单。基于工具去搭 UI 工程,落地门槛比编译器路线低。
由于公司非常多的项目使用 .csd 等序列化文本 UI 工程,因此我们能发现大家基本都选择了 DSL 的思路,让 LLM 生成 JSON 或者其他形式的 IR 后通过编译器去生成最终的结果。G85 有个有趣的尝试:让 Agent 先在 Figma 里把 UI 结构搭出来,作为唯一可信源,导出仍然走编译器,但效果确实更好。我猜原因在反馈,Figma 的接口比自研编辑器的 MCP 更成熟,模型每改一步都能更快知道发生了什么。这也是我倾向工具路线的理由,尽管只有一个案例,还不够下定论。
从运行时反馈到 Benchmark:系统怎么知道这一版更好
工具把 UI 工程暴露给了 Agent。但它能看见多少,看见之后又能不能判断自己做错了?
这取决于反馈系统。视觉相似度只能回答最终画面像不像。UI 工程还需要检查节点结构、资源引用和控件类型,进入编辑器以后也要看加载日志与交互状态。反馈要说明错误发生在哪里、应该回到哪个节点修。上一节说的反馈,指的就是这个。
运行时反馈用于修正当前这次生成,Benchmark 则把同一套检查固定在一组代表性案例上,用来比较不同版本。提示词、工具或工作流发生变化以后,系统有没有进步、是否引入回归、错误从哪一层转移到了哪一层,都应该能够重新跑出来。运行环境和评测环境最好共用校验器。反馈与 Benchmark,本来就是同一份工程投入。
只有运行时反馈和 Benchmark 也不是完全足够的。Anthropic 的 C 编译器实验依靠测试集、CI 和 GCC oracle 推动 Agent 迭代,最终能够编译 Linux,但代码质量不足。反馈可以把系统推向可运行的目标,却不会自动定义可维护性和人的品味。
模型继续变强以后,通用知识和固定流程的注入会减少,项目规范、组件习惯和人的判断却不会自动进入模型。对于需要长期维护、多人协作和稳定上线的商业 WebUI,完全 Vibe 依旧不现实。对于用于游戏 UI 开发的 AI Agent 系统,既要在前向把项目约束和人的品味交给模型,也要在后向用运行时反馈和 Benchmark 检查它是否真的遵守;缺少任何一边,最后更容易得到的仍然只是 Demo。
在这一节我们强调多源的反馈,除了最终的视觉效果以外,日志、文件结构、规范遵守都应该成为反馈信号的一部分。成熟项目开发有自己的习惯与规范,这些内容需要作为被校验的反馈和生成时注入的知识。也有方案只拿最终视觉效果和切图去拼 UI。画面能对上,但设计稿、交互稿、项目规范里的东西全被丢掉了,进了编辑器就能看出来。
多状态组件、字体、动效与程序
字体是少数适合从设计稿侧补齐的信息。设计师本来就要选择字体,把它约束到项目字体库或统一的 Text Style,增加的工作有限,也比让 Agent 根据像素猜字形可靠得多。字体信息需要从 Figma 或 PSD 里带出来,这算是少数几件不用给设计师添太多活的事,他们本来就要选字体。
多状态组件和动效都是比较难处理的问题。静态设计稿没有时间轴,也不会告诉系统悬停、按下、禁用之间如何切换,这些信息本身就不存在。对于简单的多状态组件,从控件复用的角度就可以实现,但复杂的多状态依旧离不开人工。
VX 是更复杂的问题,属性关键帧动画只需要简单的交互稿能够初步生成,很少的 UI Shader 可以复用。但对于复杂场景和粒子、Live2D、序列帧,AI 基本不存在直接完成的可能。有些工作不属于重复劳动而是属于艺术创作,我们也只能停在这里。
开发 UI 相关代码是一个独立问题,不过 AI 写代码比完成 UI 组件能力强的多。和传统的程序开发一样,UI 程序代码需要解决两个问题。一是怎么把项目规范和品味注入进去,这些东西过去只在人与人之间流转,SDD 在这里是必须的,Figma 和 UI 工程都要作为上下文补进来。二是怎么让 AI 写的代码更快得到验证,这需要更好的自动化 QA。
UI 开发的 Pipeline 很长,包含很多人的审美与内部的规范,内部流程的自动化远比 Vibe Coding 一个网页复杂的多。
Workflow or Agent:UI Agent 最终应该被做成什么形式
Workflow 和 Agent 的区别在于把多少决策留给模型,多少留作脚本。输入输出稳定、执行步骤和检查方式明确时,Workflow 可以把项目知识与失败处理直接写进代码;目标明确但路径无法提前列举时,才需要 Agent 自己选择工具、观察结果并继续探索。UI 生产这两种工作都有,所以两边都得要。
没有必要照着策划、GUI、UIP、程序的岗位划分去做一组角色 Agent。人类分工来自技能和精力的限制,把这套组织结构搬给模型,只会重新引入上下文交换和沟通成本。Agent 的拓扑里应该只有任务,没有为了模仿人的职能而创造的角色。
更现实的形态是用 Workflow 固定预处理、编译、装配和验证,把语义判断、资产检索与失败回修留给 Agent;人工则负责补充设计意图,并确认那些无法被规则和反馈判断的结果。它在使用方式上可以是 UIP 的 Copilot,在系统内部则按 Benchmark 证明可靠的程度,逐步接管一段完整流程。依赖项目经验和人的品味的部分也需要保留人机协作。
在之前的大量讨论中,我们在结合现有的 UI 工作流思考我们的产品的定位。现实中的组织结构会作用于 Agent 的开发,而 AI Agent 的出现也会反作用于组织结构本身。游戏行业本身就不像传统移动互联网一样有明确的分工,在一些小的工作室中,UX 和 GUI 一体是常态,程序也经常兼顾拼接的工作。UI Agent 在程序方面的自动化进度比 UIP 快得多,当辅助工具做得足够好,那么整个 UI 工作链可能就只需要策划和开发两个岗位,前者处理想法与实现视觉效果(结合目前的 AIGC Agent),后者思考 UI 结构与程序逻辑,这可能是未来的组织结构。
Take Home Messages
设计稿和 UI 工程之间隔着一整层语义 控件类型、交互状态、数据绑定、自适应规则,都不在输入里。确定性脚本补不出这段信息,要求设计师提前标注则是把活推给上游。生成式模型第一次让这段缺失有机会被补上。它仍然是在猜,但这是第一个不增加别人工作量的解法。
别让模型碰它不擅长的东西 不写几千行 JSON,改写一份 IR;不靠手册串流程,改用一张声明出来的图;不每次从头生成,改成在参照件上只动蓝图圈定的部分。每一次都是同一件事:缩小模型的动作空间,把确定的部分交给确定性代码。尽可能的为 Agent 提供足够多的可用信息而不是完全依赖视觉效果。
格式决定路线,反馈决定上限。 序列化文本适合 IR 加编译器,声明式格式可以直接生成,二进制资产只能走工具。但能不能生成只是一半。Coding Agent 这半年的进展有很大一部分来自代码天然拥有便宜而密集的反馈,UI 没有。构建更好的反馈信号是未来需要考虑的工作,而这条路线上工具比编译更加的通用和可靠。
今天该做的是 Copilot,不是接管。 Workflow 固定预处理、编译、装配和验证,Agent 负责语义判断、资产检索和失败回修,人补设计意图,人机协作才是目前应该聚焦的方向。存量项目 UI 工作流的完全自主距离仍旧遥远。
- 标题: 正在取代前端工程师的 AI,做不出游戏里最简单的一块面板
- 作者: Hyacehila
- 创建于 : 2026-08-08 12:00:00
- 链接: https://hyacehila.github.io//blog/2026/08/08/ui-pipeline-automation-thinking/
- 版权声明: 本文章采用 CC BY-NC-SA 4.0 进行许可。