
探索性数据分析:描述统计、可视化与数据预处理

探索性数据分析思想概述
数据分析是什么
数据分析 是一个统计学的新方向 缺少一个准确的定义
- 它不要求我们给方法的不确定度一个准确的度量,这在经典的统计学中的参数估计,假设检验中都是不可缺少的;
- 它重视方法的抗干扰性(稳健性) 和效率达到了同一个水准
现有的数理统计学 对度量不确定性非常的重视 但是他们为了这样精确的度量往往依赖于各种假设,随后导致数理统计学重理论而轻应用;
数据分析的出现,是对这个思想的一次改变,我们将事情的重心转移到了让数据说话之上,用一些不太正式的手法处理我们的数据,为后面的证实阶段提供基础,不再考虑为他们的不确定性的准确的度量
——陈希孺 探索性数据分析中文版序
探索性数据分析是什么
简单来说:探索性数据分析是连接经典的统计分析和流行的数据挖掘与机器学习(也是经典统计学中建模的那些内容)的一座桥梁
他的作用只有一个,就是让我们理解数据,从不同的角度了解数据
EDA(exploratory data analysis)属于统计学的一个新兴部分,与之相对的概念是 CDA 验证性数据分析
数据分析分为两个阶段,探索性的和验证性的,我们只有交替使用才能给出正确的分析结果
这种探索没有预设观点和假设,而是希望使用探索的结果来提出一些观点和假设用于后续的建模 也就是CDA,两者是不可分离的
非常明显的,EDA应该属于一种非参数的方法
EDA中都有什么内容
科学可视化是EDA中相当重要的一个部分 它隶属于统计图形的范畴 我们在 R 统计可视化 中进行单独的介绍
描述性统计作为统计学导论的内容 我们也进行单独的研究 描述性统计与可视化 我们原本可以把这些内容全部归类到EDA中
概率密度估计的主要部分都在描述性统计中进行了介绍。至于更深一步的验证工作,则属于非参数统计的范畴,可以结合描述性统计与可视化中的分布形状内容一起理解。
数据预处理也应该属于 EDA 的内容,它是后续数据分析的基础,本文后面会单独介绍。
除此以外,特征工程也是机器学习领域的重要预处理方法,它包括特征筛选、特征构造和降维等内容。
探索性数据分析的特性
根据 David 和 Tukey 出版的 Understanding Robust And Exploratory Data Analysis 对探索性数据分析做过介绍
Robust 在目前的工业界被翻译成鲁棒性 陈忠琏教授翻译为 耐抗性 有时我们也把它称为稳健性 在这里我们不纠结翻译的细节 其核心意义在于
稳健性要求数据分析方法对数据的局部不良的不敏感性 这种不良在局部,但是可能变化巨大
那么探索性数据分析和稳健性有什么联系? 稳健性和探索性数据分析是整体而非泾渭分明 稳健性是我们对探索性数据分析的要求 所有的探索性数据分析方法都应该尽量对异常不敏感
因此 分位数作为高稳健性数字特征的代表在EDA中的使用非常的广泛 ,包括五数概括 箱线图 分位差 等等手段 这些我们在描述性统计的EDA部分有过介绍 描述性统计与可视化中的 EDA 离散度量内容 描述性统计与可视化中的集中趋势度量内容
Know our Data
描述性统计
描述性统计分析是了解数据的最基本方式 它在经典统计学中就被我们研究过了 描述性统计与可视化
数据可视化
除此以外 数据可视化技术也是EDA的重要一部分 R 统计可视化
数据预处理
数据预处理的基本介绍与常见问题
数据预处理的基本介绍
在开篇之前 我们先来一张图体现数据挖掘(数据分析)全流程
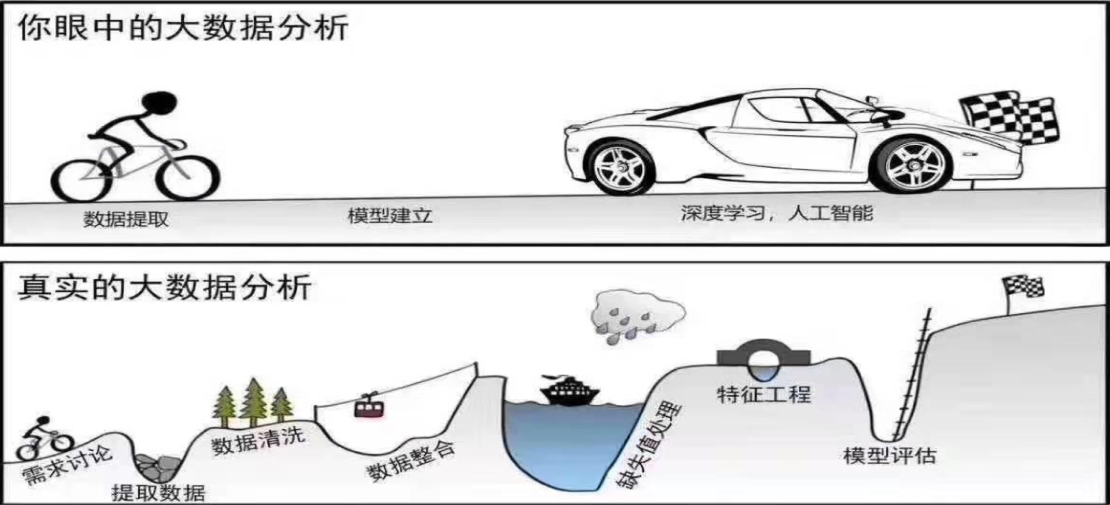
预处理数据是数据挖掘工作中最基础的内容,但也恰好是数据挖掘中最耗费时间的一部分,是 Kaggle 等数据科学平台容易弱化的一部分,里面包含着大量工作。
数据和特征决定了机器学习的上限,而所选模型和算法只是去逼近这个上限 这就是特征工程和本文的数据预处理部分的作用
数据预处理的常见问题
这里我们回应为什么要做数据预处理 预处理针对哪些情况进行
对于数据对象,我们能得到未经处理的特征(属性),这时的特征可能有以下问题
- 不属于同一量纲:即特征的规格不一样,不能够放在一起比较(统一单位)
- 信息冗余:对于某些定量特征,其包含的有效信息为区间划分,例如学习成绩,假若只关心“及格”或 “不及格”,那么需要将定量的考分,转换成“1”和“0”表示及格和未及格(定量转定性)
- 定性特征不能直接使用:某些机器学习算法和模型只能接受定量特征的输入,那么需要将定性特征转换为定量特征(定性转定量)
- 存在缺失值:缺失值需要补充(补充缺失)
- 当数据维数过高时,还会存在所谓的“维数灾难(Curse of Dimensionality)”问题 (数据降维) 我们留在特征工程中再讨论特征工程中的数据降维内容
特征提取与类型转换
想要预处理数据,首先需要得到数据。实验或业务系统中拿到的大量数据,往往有很大一部分对研究问题没有直接作用,并且经常是非结构化的。此时就要进行数据挖掘工作的第一步:特征提取与类型转换。
创建一组可供分析师使用的特征数据,将特征数据转换为统一的表达形式
如何进行特征提取取决于我们要解决的问题,往往还依赖分析师的经验,至于类型转换 我们有一些经验可以遵循 这些内容仅供参考
| 源数据类型 | 目标数据类型 | 方法 |
|---|---|---|
| 数值型 | 类别型 | 离散化 |
| 类别型 | 数值型 | 二元化 |
| 文本 | 数值型 | 潜在语义分析(LSA) |
| 时序 | 离散序列 | 符号聚合近似(SAX) |
| 时序 | 多维数值型 | 离散小波变换(DWT);离散傅里叶变换(DFT) |
| 离散序列 | 多维数值型 | 离散小波变换(DWT);离散傅里叶变换(DFT) |
| 空间 | 多维数值型 | 二维 DWT |
| 图 | 多维数值型 | 多维标度(MDS);图谱转换 |
| 任何类型 | 图 | 相似图(可用性较有限) |
作为强经验依赖的内容 这里不展开介绍了 在不同的领域都有自己的方案 没有通用的方法
复杂特征分解
某些特征字段可能包括大量信息,比如一个字段包含了年月日时分秒,对我们有价值的信息藏在其中,但不能直接使用,这就是复杂特征分解需要处理的问题。
字符串拆分:以泰坦尼克数据集为例,舱位编号如 C123 表明乘客身份信息,从其中拆分出的 C 等舱这一信息很可能对预测有效,这就是字符串拆分。
时间戳拆分:依赖我们的感觉,考虑保留年月日时分秒中的哪一种信息,比如四季、工作日与休息日等;如果有时区信息,还需要考虑如何统一它们,同时时区信息也可以作为独立特征揭示地理位置信息。
位置信息拆分:经纬度、国家等都属于位置拆分信息的一部分;我们往往希望分开考虑经纬度,这样一般才会有更好的效果。
常见数据预处理方法
我们后面将介绍下面的数据预处理方法 这里一定不是完全的,因为很多方法都在其他课程内容中学习 这里加入链接即可
- 数据清洗:数据清洗处理数据的某些记录值缺失,平滑数据中的噪声、发现异常值,改正不一致等
- 数据融合:将不同来源的、异质的数据融合到一起。良好的数据融合可以减少数据中的冗余和不一致性,进而提升后续步骤的精度和速度
- 数据转换:通过平滑聚集,数据概化,规范化等方式将数据转换成适用于数据挖掘的形式
- 数据降维:将高维度数据化为低维度数据,仍保持原数据的大部分信息,使数据挖掘结果与降维前结果相同或几乎相同
相关的理论支撑
Codd 关系代数第三范式:整理数据是为了让数据的结构布局有含义,也就是说
- 每个特征都在一列中
- 每个实例都在一行中
- 每种特征都应该只存在一个表中
- 如果特征存在于多个表中,那么就有一列把它们连接起来 这就是我们为什么要整理数据
数据清洗(Data Cleaning)
我们直接介绍需要干的事情就好了
缺失值处理
缺失值在实际数据中是不可避免的问题,对于不同的数据场景应该采取不同的策略,首先应该判断缺失值的分布情况
- 如果缺失值极少且这个维度信息不重要,一般删除它们对于整体数据情况影响不大;
- 如果缺失值较多或这个维度的信息还很重要的时候,直接删除会对后面的算法跑的结果造成不好的影响,我们需要考虑插补数据了
缺失一般分为三类
- 完全随机缺失MCAR(和任何其他变量与自己无关的缺失)
- 随机缺失MAR (和其他观测变量相关的缺失)
- 非随机缺失MANR(和自己的取值相关的缺失)
其中 MAR最普遍 我们一般假设这种情况 只有这样基于建模插补才是可行的
均值或中位数填充
它不会减少样本信息,处理简单,但是当缺失数据不是随机数据时会产生偏差; 对于正常分布的数据可以使用均值代替,如果数据是倾斜的,使用中位数可能更好
插补技术思想
- 随机插补法——从总体中随机抽取某个样本代替缺失样本;
- 多重插补法——通过变量之间的关系对缺失数据进行预测,例如利用蒙特卡洛方法生成多个完整的数据集,最后对分析结果进行汇总处理,这是一种相对稳健的插补技术,非常的推荐
- 热平台插补——在非缺失数据集中找到一个与缺失值所在样本相似的样本(匹配样本)利用其中的观测值对缺失值进行插补 也就是 临近插补
建模插补技术
可以用回归等基于推理的工具归纳确定。
例如,利用数据集中其他数据的属性,可以构造一棵判定树(回归方程),来预测缺失值的值
一般是综合各种建模插补技术进行多重插补(Multiple Imputation,简称MI)
保留缺失技术
- 如果是分类问题,缺失可以作为一种类别被使用
- 如果模型愿意接受NA的存在,保留NA作为缺失嵌入给后面的模型
缺失有时候是一种信息
对于随机缺失,我们只能使用插补的手段来处理。但是对于很多涉及非纯数据挖掘的问题,缺失很多情况下存在规律性,比如某个业务部分的工作失误产生的缺失,收集数据的手段本身存在问题产生了缺失,如果可以发现缺失产生的原因的话,我们可以重新针对性的处理数据来填补缺失,甚至有时候缺失数据就可以通过其他已有的数据进行非常可信的推算。
还有的时候,缺失本身也是一种可以考虑的信息。将缺失本身作为一种信息纳入模型也是有价值的,某些数据的缺失暗含了用户本身的特征。
异常值处理
异常值我们通常也称为“离群点”(outlier),即在样本空间中,与其他样本点的一般行为或特征不一致的点。一般可能有如下产生原因:
- 计算的误差或者操作的错误所致(错误数据)
- 数据本身的可变性或弹性所致(真实的特殊数据)
离群点不一定是无用数据,它也许正是用户感兴趣的,比如在欺诈检测领域,那些与正常数据行为不一致的离群点,往往预示着欺诈行为,因此成为执法者所关注的。
对于离群值我们的处理方案也不唯一
- 删除离群是最常见的处理方法
- 如果确实想保留这个样本 我们一般采用视为缺失后的插补方法
- 如果算法对离群不敏感 不处理离群值也是可以的
基于统计分布的离群点检测
这类检测方法假设样本空间中所有数据符合某个分布或者数据模型,然 后根据模型采用不和谐校验( discordancy test )识别离群点
正态分布的 原则 使用箱线图进行离群点检测都属于这个范畴
基于距离的离群点检测
正如我们基于距离进行聚类分析一样,那些孤独的类可以被视为离群点。这里可以参考机器学习中关于距离计算与层次聚类的内容。 实际使用中,那些离其他点距离过远的点会被视为离群点。
基于密度的离群点检测
类似地,也可以从密度聚类的角度理解离群点。 实际使用中,那些密度过低的点会被视为离群点。这种方法可以同时检测出全局离群点和局部离群点。
数据去重
数据重复在实际生活中很常见,在一些数据挖掘模型中,这些冗余的数据加大了数据分析的难度和处理速度,因此需要对数据去重
常见的方法有
- 遍历数据搜索——复杂度高,仅适用于数据规模较小的情形
- 哈希表示——生成数据指纹,简单高效,适用于大规模数据,代表算法:
- Bitmap:位图法;
- SimHash:相似哈希;
- 布隆过滤器
很多模型并不需要数据去重工作
数据去噪
噪声,是被测量变量的随机误差或方差;大部分数据挖掘方法都将离群点视为噪声或异常而丢弃,但确实有专门研究噪声的数据挖掘方法
观测量(Measurement) = 真实数据(True Data) + 噪声 (Noise)
常见数据去噪方法有
- 分箱法:考察数据的“近邻”(即周围的值)来光滑有序数据值
- 回归法:用一个函数拟合数据来光滑数据,能够帮助消除噪声
大部分模型(尤其统计模型)并不需要数据去噪工作
手工删除无用的特征
手工删除无用的特征高度依赖我们的经验,这里是对一些基本经验的总结。它是从数据本身的角度进行移除,那些基于业务的手工过滤特征在这里无法被介绍:
- 删除明确无作用的量:如观测的编号,理论上不会对模型有任何正面作用
- 删除缺失值比率过高的量:没有固定的线,根据情况决定
- 删除方差几乎为 0 的特征:
- 变量取值的个数不到变量个数的百分之十
- 频数最大的两个取值,频数比值超过百分之二十
- 删除复共线性太强的量:
- 找到目前相关系数最强的两个变量
- 计算它们和剩余总体的相关系数(复相关系数)
- 删除复相关系数最大的变量
- 是否需要重复这个步骤继续进行删除,要从数据集的情况来看
- 基于相关系数进行筛选,保留较强相关的量(见描述性统计与可视化:相关分析)
数据融合(Data Integration)
我们还是介绍需要做一些什么
数据融合将不同来源的、异质的数据融合到一起。良好的数据融合可以减少数据中的冗余和不一致性
在实际的使用中 数据融合往往根据数据的情况来决定 比如:实体识别问题(Entity Identification Problem):尝试匹配不同的数据源中指向现实世界相同实体的纪录
更多的内容这里不再介绍了
数据转换(Data Transformation)
数据转换有着很庞大的内容 他们的目的都是将数据从一种表示形式变为另一种表现形式,满足数据挖掘的条件
这里我们介绍一些比较基本的数据转换方法 实际上在统计学中数据变换已经成为了一门学科 有着非常多的研究
常见的数据转换方法大致可分为如下几类:
- 离散化
- 二值化
- 归一化与标准化
- 特征编码
离散化
有些数据挖掘算法,特别是某些分类算法,要求数据是分类属性形式或者分类形式可以有效提升算法工作效率
这样,常常需要将连续属性变换成分类属性(离散化,discretization),并且连续和离散属性可能都需要变换成一个或多个二元属性
常见离散化方法有:
- 无监督:分箱法(等宽/等频)、直观划分,中位数分组 等
- 有监督:chimerge法 MDPL法,CAIM法等 监督离散化方法是对那些缺少直觉和领域知识的FE工作者的好方法
我们提示过离散化要谨慎R 统计可视化中关于谨慎处理数据的讨论,但此时我们必须离散化,保持警惕就好
分箱法的一种习惯规则如下
- 组数在5到20之间 数据越多分组数越多
- 组距尽可能相同(等频分组时除外)
- 组距尽可能选取奇数,当然根据情况选偶数也可以
- 最小组下限 最大组上限覆盖全部个体,但也要尽可能避免溢出过多
- 尽量避免使用只有上限或者只有下限的分组
二值化
特征二值化是把数值特征转化成布尔值的过程,其核心在于设定一个 阈值,大于阈值的赋值为 1(true),小于等于阈值的赋值为 0(false)
归一化与标准化
归一化是一种简化计算的方式,即将有量纲的表达式,经过变换,化为 无量纲的表达式,成为标量
标准化旨在统一数据量纲 提升算法可解释性,于此同时,在那些需要梯度下降的算法中,统一量纲有助于加速梯度下降的收敛。
在传统机器学习与统计学中,归一化与标准化是必不可少的;在深度学习领域,我们还研发出了更多中归一化方法来帮助梯度下降的执行。
常见的方式有
- 基于极值归一化: 会导致异常值被挤压到小区间,所以应在处理完异常值之后进行
- 绝对值最大归一化:
- z-scores变换:
- 十倍缩放:
- Robust scaling :
- 范数归一化:
数据合并
离散化将原本连续的数据变为多个分类指标,降低了类别的颗粒度,于此同时降低了模型运算的开销。
数据合并是针对离散型数据的又一次离散化。有时候分类数据的类别过多,可能存在上百个类别,这样使用特征编码后会得到过多变量。
数据合并的目标是降低变量类别的数目。常见方法有:
- 根据我们对变量的理解,将某些类别手工的合并
- 对于那些占比低于百分之二十(习惯规则)的类别,将他们全部合并为一个OTHERS类别,这个类别也可以作为插补的手段,也就是稀疏类别合并
特征编码
特征编码是针对分类自变量产生的思想 我们在广义线性回归中关于分类自变量与虚拟变量的问题中进行讨论
特征构造:交叉与坐标特征
特征构造是指根据经验将原本的数据进行加工,得到对模型更有意义的特征。它要求你在样本数据上花费大量时间,思考问题的本质、数据的结构,以及怎么最好地在预测模型中利用它们。 可计算特征指将已有特征输入后进行计算,计算结果作为新的特征。它更适用于简单的 ML 模型(如线性回归交互项);神经网络一般被认为可以自主学习可计算特征,当然我们引入可计算特征到 NN 中也可能提升效果。一般情况下,可计算特征研究三类问题:单特征变换(见数据变换一节)、特征算术组合、特征坐标系概念变换。
特征算术组合:特征的算术组合也称为”多项式特征”。如果某种特征组合在问题领域内有意义,就可以把它显式地添加进来。例如,如果有长度和宽度两个特征,那么面积(长度乘以宽度)就有同样的作用。添加这种组合需要一定的直觉,添加所有算术组合会是一个错误——因为特征组合的空间非常大,应该使用尽可能多的领域知识来指导。
笛卡尔积:如果两个特征总是同时出现(如楼层和房间号),那么使用这两个特征的笛卡尔积作为一个单独特征可以加强信号,供 ML 算法使用。这是分解复杂特征的逆操作。
特征坐标系概念变换:如果我们认为两个向量的角度是有意义的,那么就可以考虑使用极坐标系,方便模型学习角度特征;如果想要降低相关性,那么马氏距离完成的旋转坐标系就可以被考虑。对于颜色特征,我们也有 RGB、HSV 等编码方式,它们有着自己的编码特点。
特征选择与稀疏学习
特征选择是从大量的特征中选择少量的有用特征。不是所有的特征都是平等的:与问题不相关的属性需要被删除,有些特征比其他特征更重要,也有的特征与其他特征是冗余的。特征选择就是自动地选择对问题最重要的特征的一个子集。
特征选择的作用是:
- 简化模型,增加模型的可解释性
- 缩短训练时间
- 避免维度灾难
- 改善模型通用性、降低过拟合
特征子集选择的方式主要有三类:
- 嵌入(embed):学习算法本身包含特征选择步骤,比如决策树;
- 封装(wrapper):特征选择与训练过程整合,用训练出的模型效果进行特征选择,比如 LVW(Las Vegas Wrapper);
- 过滤(filter):特征选择与训练完全独立,根据特征本身进行选择,与学习器无关。
过滤式
过滤式特征选择考虑自变量与目标变量之间的关联来筛选特征,评价标准从数据集本身的内在性质获得。研究者认为,相关度较大的特征或特征子集会在分类器上获得较高的准确率。过滤式特征选择的评价标准分为四种:距离度量、信息度量、关联度度量以及一致性度量。
优点:算法通用性强;省去了分类器的训练步骤,算法复杂性低,因而适用于大规模数据集;可以快速去除大量不相关的特征,作为特征的预筛选器非常合适。
缺点:由于评价标准独立于特定的学习算法,所选特征子集在分类准确率方面通常低于 Wrapper 方法。
Relief 方法:使用 Relief 方法就可以有稳定地进行过滤(filter);它本质上就是在研究相关性。该方法设计了一个”相关统计量”来度量特征的重要性。该统计量是一个向量,其每个分量分别对应于一个初始特征,而特征子集的重要性则由子集中每个特征所对应的相关统计量分量之和来决定。最终只需指定一个阈值 ,选择比 大的相关统计量分量所对应的特征即可;也可以指定欲选取的特征个数 ,选择相关统计量分量最大的 个特征。
这个相关统计量的计算方法为:给定训练集 ,对每个示例 ,Relief 先在 的同类样本中寻找其最近邻 ,称为”猜中近邻”(near-hit),再从 的异类样本中寻找其最近邻 ,称为”猜错近邻”(near-miss)。相关统计量对应于属性 的分量为
其中 表示样本 在属性 上的取值, 取决于属性 的类型:若为离散型,则 时为 0,否则为 1;若为连续型,则为 。注意 已规范化到 [0,1] 区间。
它本质上是在计算某个特征在”猜错”与”猜对”之间是否有明显作用:如果有,就增大相关统计量对应的分量,最后平均各个样本的情况就是最终输出。Relief 是为二分类问题设计的,其扩展变体 Relief-F 能处理多分类问题,不过它们对于定性自变量都没有什么作用。
封装式
封装式(Wrapper)特征选择利用学习算法的性能评价特征子集的优劣。对于待评价的特征子集,Wrapper 方法需要训练一个分类器(需要人为指定),根据分类器的性能对该特征子集进行评价。
优点:相对于 Filter 方法,Wrapper 方法找到的特征子集分类性能通常更好。
缺点:Wrapper 方法选出的特征通用性不强,当改变学习算法时需要重新进行特征选择;由于每次评价子集都要进行分类器的训练和测试,算法计算复杂度很高,尤其对于大规模数据集来说执行时间很长。
具体的封装方法研究往往是搜索手段的研究,如:
- 递归特征消除法
- 贪心思想的前后项搜索方法
- 随机搜索方法
稳定性选择(Stability Selection):稳定性选择是一种基于二次抽样和选择算法(训练模型)相结合的方法,选择算法可以是回归、分类 SVM 或者类似算法。原理实现:在不同的特征子集上运行训练模型,不断重复,最终汇总特征选择的结果。比如可以统计某个特征被认为是重要特征的频率(被选为重要特征的次数除以它所在子集被测试的次数)。理想情况下,重要特征的得分会接近 100%;稍微弱一点的特征得分会是非 0 的数;最无用的特征得分会接近于 0。特征值下降的不是特别急剧,这跟纯 LASSO 和随机森林的结果不一样,能够看出稳定性选择对于克服过拟合和对数据理解都是有帮助的。总的来说,好的特征不会因为有相似的特征、关联特征而得分为 0。在许多数据集和环境下,稳定性选择往往是性能最好的方法之一。
递归特征消除(Recursive Feature Elimination,RFE):RFE 的主要思想是使用一个基模型(比如 SVM 或回归模型)进行多轮训练:每轮训练后根据每个特征的系数打分,去掉得分最小的特征,用剩余的特征构建新的特征集,再进行下一轮训练,直到所有特征都遍历完。具体步骤为:
- 反复地构建模型(比如 SVM 或者回归模型);
- 选出最好(或最差)的特征(可以根据系数来选),把选出来的特征放到一边;
- 在剩余的特征上重复上面 1、2 步骤,直到遍历完所有特征。
这个过程中特征被消除的次序就是特征的排序,实际上这是一种寻找最优特征子集的贪心算法。RFE 的稳定性很大程度上取决于迭代选择时选择哪一种模型:
- 如果采用普通回归,没有经过正则化的回归是不稳定的,从而 RFE 也是不稳定的;
- 如果采用 Ridge 或 Lasso 模型,经过正则化的回归是稳定的,从而 RFE 是稳定的。
特征值排序:理论上来讲,如果某个特征进行排序或者打乱之后,会很明显地影响(无论正向还是负向)模型(预测评分)效果,那么可以说明这个特征对模型来说是重要的;反之,说明这个特征存不存在并不会影响模型的效能。特征值排序就是基于这样的思想设计的方法。
嵌入式
嵌入式特征选择将特征选择过程与学习器训练过程融为一体,两者在同一个优化过程中完成,即在学习器训练过程中自动地进行了特征选择。对于嵌入方法,正则化回归是最好的例子: 正则化更容易得到稀疏解,因此一般把基于 正则化的学习方法称为嵌入式特征选择方法,其特征选择过程与学习器训练过程融为一体、同时完成。Ridge、LASSO、ElasticNet 的具体推导见线性回归基础。
除去基于正则化思想以外,基于树模型的嵌入式特征选择也使用得非常普遍:决策树、梯度提升树都是嵌入式特征选择的模型。深度学习也是一种嵌入的特征选择方法。
稀疏表示与字典学习
特征选择所考虑的问题是特征具有”稀疏性”,即矩阵中的许多列与当前学习任务无关,通过特征选择去除这些列,提高模型效果、可解释度,降低训练的难度。
现在来考虑另一种稀疏性: 所对应的矩阵中存在很多零元素,但这些零元素并不是以整列、整行形式存在的。当样本具有这样的稀疏表达形式时,对学习任务来说会有不少好处:高度的稀疏性使大多数问题变得线性可分,所以 SVM 在这种数据中会有着很好的效果;同时,稀疏样本并不会造成存储上的巨大负担,因为稀疏矩阵已有很多高效的存储方法,所以这种稀疏性是我们在追求的。
这种适当的稀疏对我们进行模型的构建是有好处的(当然过度的稀疏数据是不好的)。那么,若给定数据集 是稠密的,即普通非稀疏数据,能否将其转化为”稀疏表示”(sparse representation)形式,从而享受稀疏的好处?
显然,在一般的学习任务中(例如图像分类)并没有《现代汉语常用字表》可用,我们需要学习出一个这样的”字典”,为普通稠密表达的样本找到合适的字典,将样本转化为合适的稀疏表示形式,从而使学习任务得以简化、模型复杂度得以降低。这通常称为”字典学习”(dictionary learning),亦称”稀疏编码”(sparse coding)。
给定数据集 ,字典学习最简单的形式为
其中 为字典矩阵, 称为字典的词汇量,通常由用户指定, 则是样本 的稀疏表示。显然,优化式第一项是希望由 能很好地重构 ,第二项则是希望 尽量稀疏。
数据变换
在非常多的情况下 我们需要对原始数据进行一定变换才能更好的体现数据特征;这往往是因为 原始数据具有
- 强非对称性
- 大量离群值
- 对简单模型的拟合呈现了大并且非偶然的残差
- 箱线图衍生的中位数与四分位差图体现了他们两者的相依关系 我们希望通过对原始数据进行一些形状上的调整 来让进一步的分析更加的合理 后面我们会介绍 什么时候需要变换 做什么样的变换等等 变换 是一个非常广义的概念 映射为常数 映射为次序量 都算是变换 但是我们在后面只研究一类特殊的变换 他要求
- 中位数次序保持不变
- 连续且光滑的函数
- 初等函数就可以构造形成 以有简单的计算形式 变换是有代价的,并不是所有时候变换都能带来好处
幂变换
定义 幂变换有下面的表达形式
里面的参数可以比较自由的选取 但是需要保证满足我们前面要求的变换的性质 幂变换有下面三种比较常用的形式
做变换的理由
数据的内在要求
比如我们有时候希望把摄氏度转化为华氏度,把人口的数量进行对数化(因为增长是指数的),这些变化基于数据本身的特征 往往依赖于我们对这一类数据研究的经验 进行他们可以有益于进一步的分析
为对称性变换
箱线图和偏度系数可以告诉我们数据是否存在系统性的偏斜,这往往是我们不希望的 所以要研究数据如何对称化
- 基本的 我们会尝试平方根变换 也就是
- 如果尽管如此还是不够对称 我们考虑对数变换 也就是
- 对数变换一般也可以用 代替
为了消除四分位差和中位数的依赖性
消除这种依赖性往往被认为更适合进行直观的探索性的分析
为了构造变量的近似线性关系
近似线性的模型更加容易的进行简单的拟合 进而分析残差
什么时候变换是值得的
我们并没有一个严格确定的标准 下面是一些参考的分析方式
- 最大数据值和最小数据值的比较大 一般认为是20以上
- 该领域有进行这样变换的习惯
- 残差较大并且呈现了某种规律
从习惯出发时变换最广泛的应用
Box-Cox变换
Box-Cox变换的意义是让前面的线性回归模型符合我们需要的所有假设 它包括Gauss-Markov假设 线性相依假设 正态误差假设 实际上这是对回归诊断出现问题后的一个修正方式 注意,Box-Cox 变换不是单一变换,而是一个变换族。 Box-Cox变换族的整体表示
明显的 选择怎么样的Box-Cox变换的核心是选择合适 事实上 我们并没有解析的方式来得到一个稳定的 在实际的操作中 我们会选择大量的 分别进行非常多的Box-Cox变换 根据各种信息量准则确定 我们此时的核心目标只有
- 方差齐
- 满足正态性假设
马氏距离变换:马氏距离是通过旋转坐标轴后的欧式距离实现的,可以消除自相关性
白化
马氏距离变换消除了自相关性,标准化变换换来了单位方差,同时综合这两者的方法就是白化。白化产生的数据非常适合各种模型的建模分析,比较常见的白化方式有 PCA(主成分分析)白化和 ZCA 白化。白化是一种数据变换的方式,但是由于其较为高级,常常被放入特征工程中讨论。
除了白化,另一个常用的单特征变换是 Sigmoid 操作。它有着 S 型的函数,可以保持数值域中间部分的可变性,而减少值域两端的可变性:
- 标题: 探索性数据分析:描述统计、可视化与数据预处理
- 作者: Hyacehila
- 创建于 : 2024-02-29 13:41:47
- 链接: https://hyacehila.github.io//blog/2024/02/29/exploratory-data-analysis-learning-notes/
- 版权声明: 本文章采用 CC BY-NC-SA 4.0 进行许可。